一、这条新闻里最反常的一句话
2026 年 10 月 15 日,Meta 发布 **Muse Spark Open**,并在官方博客中称其为「迄今美国能力最强的开放权重模型」(the most capable US open-weight model to date)。
需要注意:**这是 Meta 对自家产品的自我评价,不是独立第三方的评测结论。** 后文会看到,这句话里的「美国」两个字是加得很有必要的。
参数表本身已经足够有分量:
| 指标 | 数值 |
|---|---|
| 总参数量 | 8160 亿 |
| 单次激活参数 | 420 亿 |
| 上下文窗口 | 100 万 Token |
| 模态 | 原生多模态(文本 / 图像 / 视频 / 音频) |
| 主攻方向 | 编程、智能体、长时程任务、复杂软件工程 |
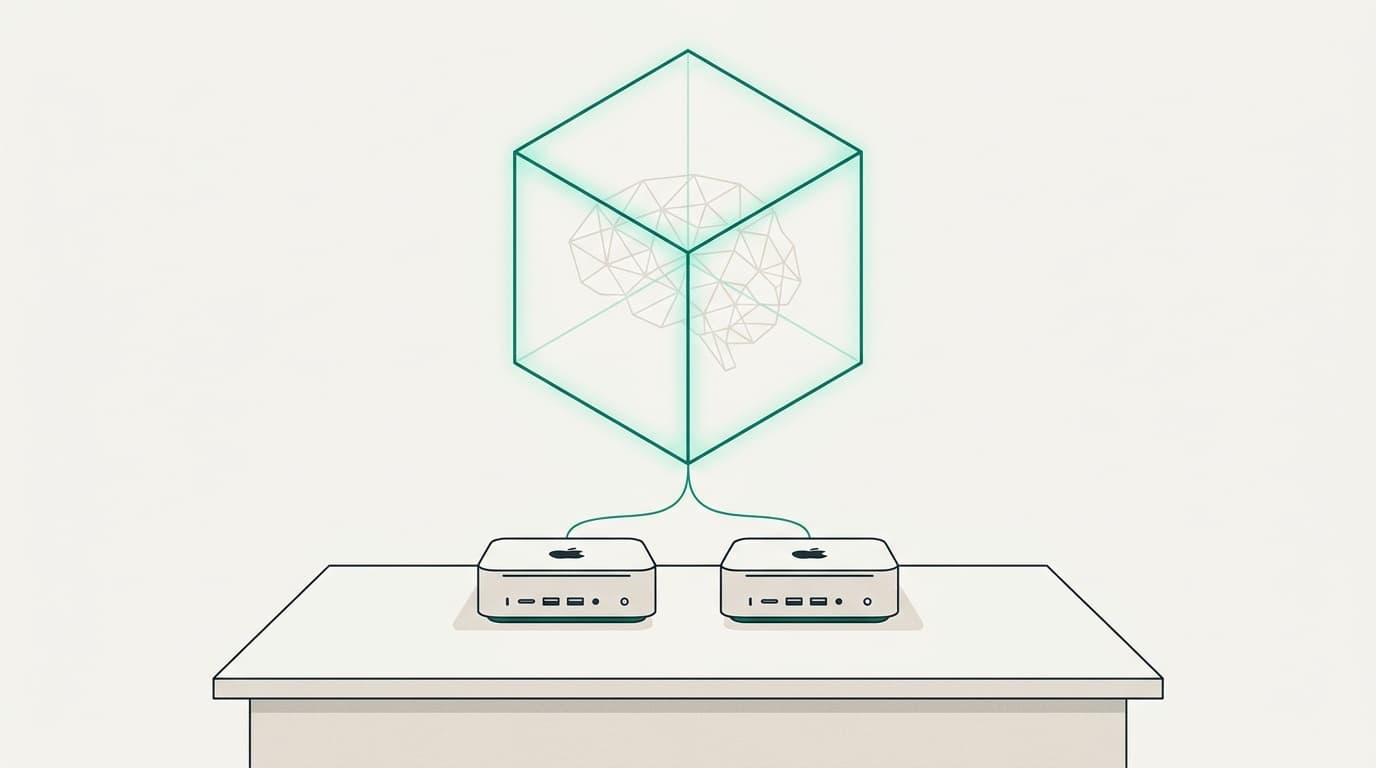
但真正让这条新闻越过「又一个模型发布」门槛的,是紧随其后的这句话:**它是同类前沿模型中,第一个可以借助最新版 MLX 框架、在搭载苹果 M5 Ultra 芯片的 Mac Studio 上本地运行的模型。** 两台。
苹果的统一内存架构让单台 M5 Ultra 的集成 GPU 最高可动用 **512GB** 统一内存,两台协同即接近 1TB。这颗芯片的内存带宽为 **1.2TB/s**(上一代 M3 Ultra 为 819GB/s),读取每个 Token 所需的那一小片权重足够快。苹果官方研究博客在 10 月 15 日的实测中给出的数字是:**四台 Mac Studio 张量并行,Muse Spark Open 的解码速度超过 36 tokens/秒**——远高于人类平均阅读速度;两台张量并行 24.99 tok/s,两台流水并行 15.74 tok/s。
需要说清楚的是,这个模型在原生 BF16 精度下光参数就要占用 **超过 1.6TB** 内存,即使换成 4-bit 的 NVFP4 量化版本,参数量也仍需约 **493GB**——所以它**不可能**在单台机器上跑起来,必须跨机并行。这是「两台」这个数字的由来,不是营销话术。
技术细节里还藏着一件更值得玩味的事:**这是 Meta 与苹果的一次罕见公开合作。** 两家公司在隐私、广告追踪、平台生态上积怨十余年。据 Axios 报道,Meta 首席 AI 官汪滔(Alexandr Wang)的形容相当传神——「我们很高兴看到爸爸妈妈又重新好好相处了」。据 9to5Mac 转述,汪滔称两家公司已经合作数月,并特别提到前苹果高管 **丹尼尔·格罗斯(Daniel Gross)**「在促成两家公司友好合作方面发挥了非常大的作用」。彭博社报道称,扎克伯格在社交媒体上专门感谢了苹果 CEO 特努斯,并附上一张新模型在 Mac 上运行的照片。
**为什么这事值得单独拿出来说?** 因为过去两年,「本地跑大模型」一直有一个心照不宣的天花板:**能在你机器上跑的,都是小一号的东西。** 设备上能跑的,永远是云端能力的缩水版;想用前沿能力,就得回到别人的机房里去租。8160 亿参数装进两台桌面设备,第一次把这个天花板顶出了一道裂缝。**但这条新闻真正的信息量,藏在两个 Meta 自己没打算强调的地方。**
二、第一个反转:Meta 没给最好的那个
同样是本周,Meta 于 10 月 12 日发布新一代模型 **Muse Wonder**,官方描述为「迄今能力最强的模型,为个人与专业智能体任务提供最先进性能」。Muse Wonder 通过 **Meta Model API 与 Muse Code** 提供服务,其中 **Muse Wonder Full 目前仅面向 Muse Code 订阅用户**;官方表示 Muse Wonder 随后将驱动 Muse 应用中的体验,并优先向订阅用户开放。Meta 在这篇公告的口径是:这是「迈向人人可得的个人超级智能的一大步」(a major step toward personal superintelligence for everyone)——**这是公司层面的官方表述,不宜直接引作扎克伯格的个人原话。** 周四开放的 Muse Spark Open,**能力弱于 Muse Wonder。**
汪滔在接受彭博社采访时把逻辑讲得很清楚:
出于安全性和能力两方面的考虑,我们通常不会开源我们最强大的模型。但我们确实认为,随着时间的推移,持续开源优秀的模型非常重要,我们打算继续这样做。
请注意这句话的结构。前半句是能力保留,后半句是生态开放。Meta 做的是一件很精确的分层动作:**把够好的一档放出去,把最好的那一档锁在自己的商业体系里。**
这套路数并不新鲜,但值得看清它的形状。把时间线摊开会更清楚:Meta 曾靠 Llama 系列把开放模型生态推了起来,但在上一轮模型竞赛中表现未达预期,扎克伯格随即重组 AI 研发体系,转向能力更强的闭源路线。2026 年 4 月 8 日 Muse Spark 发布,9 月 8 日个人智能体 Muse 在美上线,8 月 Muse Code 推出,9 月 2 日 Muse Spark 1.3 接替 Muse Spark 成为上一代旗舰——汪滔当时对彭博社称其与 Claude Fable 5.1「具有竞争力」。上一款开放权重模型是 8 月的 **Muse Glimmer(30B)**。现在它又回头开放了权重——**不是因为路线变了,是因为它找到了一个更好的分层位置。**
开放权重用来扩大开发者覆盖面、建立开发者关系;闭源前沿模型保留技术与商业优势。据彭博社报道,Meta 正在筹建自己的云业务,计划向客户销售模型访问权限与计算基础设施。汪滔的判断是,免费开放 Muse Spark Open 不会削弱这门生意,反而是入口:**用户先在自己的设备或基础设施上试用,随着应用规模扩大,再为更多算力和工具付费。** 于是这里出现第一层需要想清楚的东西:**你拿到的是权重,不是路线图。你拿到的是今天这一档,不是下一档。**
三、第二个反转:两个中国模型在跑分表上排在它前面
这一点更值得细看,而且被中文报道普遍放过了一半。Meta 官方公布的对比表显示,Muse Spark Open 在 **MCP-Atlas**(工具调用,覆盖 36 个在线 MCP 服务器上的 220 个工具)取得 **89.2**——领先于表内列出的全部竞争对手,包括中国模型;在 **JobBench**(智能体长时程任务)取得 **61.8**,对照 Thinking Machines Lab 的 Inkling 为 31.1、NVIDIA Nemotron 3 Ultra 为 27.2。Meta 自评在其列出的六项测试中取得第一,涵盖工作流程、工具调用、知识推理、知识可靠性、复杂视觉推理与图像事实问答。**但在终端编程与长周期软件工程这条主线上,它落在了后面。** 根据 SiliconANGLE 对 Meta 官方数据的整理,在 **Terminal-Bench 2.1** 上:Kimi K3 为 85,**Muse Spark Open** 为 **76.4**,GLM 5.3 与 Qwen 3.8 均高于 76.4。
这意味着一个很实在的格局变化:**「最强开放权重模型」这句话的主语,已经不能再默认是美国的了。** 汪滔在采访里说的那句「迄今美国能力最强的开放权重模型」,那个「美国」两个字,是加得很有必要的——因为如果不加,这句话就不一定成立。
顺带说一句分寸:**「美国最强」是 Meta 对自家产品的评价,不是经过全面独立验证的行业排名。** 开放权重模型的竞争力不只看参数规模,还取决于实际推理效果、运行成本、部署难度和开发者的真实使用体验。而且跑分表是 Meta 自己选的赛道——赢的那几项和输的那一项,权重未必一样。但方向是清楚的。这两年开放权重这条赛道上,中国厂商——阿里、DeepSeek、月之暗面、智谱——积累了相当规模的开发者基础。**Meta 这次回来,带着「美国最强」的标签,但摊开跑分,要和中国模型放在同一张表里比。**
四、「它们应该是美国的」:开放权重如何变成产业工具
现在把镜头拉远,看这条新闻里最值得逐字引用的一段话。汪滔对彭博社说:
世界上大多数 AI 都将运行在**开放模型**上。**它们应该是美国的。**
这是全篇最诚实的一句话,也是最不开放的一句话。前半句是技术判断:开放权重会赢下大部分部署场景,因为它便宜、可控、可定制。后半句是归属判断:**这个胜利应该由美国来收。** 请把这两句放在一起读。一家公司把权重免费发出去,同时在说这批权重应该属于哪个国家——**免费分发在这里不是慈善,是标准之争、生态之争、势力范围之争。**
回想一下这一周的其他画面,你会发现所有人都在做同一件事:**英伟达在欧洲加码。** 黄仁勋在巴黎宣布,将在未来一周内**追加约 20 亿美元**欧洲投资;加上过去一年已投入的 **80 亿美元**,英伟达在欧洲的累计投入接近 **100 亿美元**。四个法国标的已由英伟达官方博客确认:**Doctolib**(欧洲医疗科技——面向临床医生与患者的智能体)、**Entalpic**(巴黎,面向半导体表面与界面的原子级先进材料工程)、**Genesis AI**(全球机器人公司,做基础模型、数据采集、仿真与机器人硬件)、**Pigment**(巴黎,面向财务、销售、人力与运营的企业规划平台)——分属医疗、材料发现、物理 AI、企业规划四个方向。注意口径:**20 亿美元是本次新增的一笔,不是欧洲总投资。** **德国联邦政府退出**了 2025 年 11 月与 Mistral AI 和 SAP 的三方合作——那个曾被媒体称为「欧洲主权 AI 示范项目」的政企合作,框架协议搁置,改由企业「自主推进」。政府发言人表示没有向 Mistral 采购的计划。德国《世界报》引述的业界看法是,Mistral 的模型「已经落后竞争对手一年」,一些机构转向千问、Kimi、GLM。Mistral 上周发布了 Large 4。而据英伟达法国官方博客,Muse 之外的另一条线索是:**NVIDIA Nemotron 开放模型已在法国落地生产环境**——LINAGORA 与 Docaposte 拿下 CANUT 框架,使 Twake.ai 成为 **2500 多个法国公共机构**可用的主权数字工作空间;SBS 为银行搭建主权 AI 平台;达索系统在做「工业世界模型」与「虚拟伙伴」。**国内的政策面同时推进。** 工信部推出覆盖**一千余个场景**的人工智能「产业导航图」,已组织近 30 场「深度行」、对接 5000 余家企业,并设有 18 个国家人工智能创新应用先导区、近 200 项关键技术标准,配套 **600 亿元**国家人工智能产业投资基金。另外,**市场监管总局**批准发布**首批六项**人形机器人领域国家标准,将于 **2027 年 4 月 1 日**实施——包含 5 项技术要求系列标准和 1 项《人形机器人仿真测试平台技术规范》。注意措辞:这是**六项领域标准**,不是「中国首个人形机器人国家标准」。
**「开放」是手段,「主权」是目的。** 一份可以无限复制的权重文件,是国家意志最廉价也最有效的投放方式——它绕过了关税、绕过了审批、绕过了采购清单,直接落进全球开发者的硬盘里。所以当 Meta 说「开放权重」的时候,它同时在说四件事:给开发者一个入口、给云业务一个漏斗、给竞争对手一条追赶曲线、给自己的国家一个势力范围。
五、开放权重 ≠ 主权:三个必须分清的层次
这是这篇文章最想说清楚的部分。**「能下载」和「拥有」,中间隔着三样东西。**
**第一层:权重可及性(Access)—— 这一层 Meta 确实给了。** 你可以把 8160 亿参数的权重下载下来。渠道不少:Amazon SageMaker AI、Google Cloud Model Garden、Hugging Face、Microsoft Foundry Models。API 侧有 Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter、Together AI 共**七家推理服务商**在首发日就位。推理框架支持 SGLang、vLLM、TensorRT-LLM、Hugging Face Transformers、Apple MLX、llama.cpp、Unsloth,并针对 AMD、苹果、英特尔、英伟达的硬件做过优化。想微调,还有 PyTorch 和 TorchTitan。这一层是真的。**这是本周所有新闻里,对个人用户最实在的一件好事。** 它第一次让「前沿模型跑在自己的机器上」从口号变成了可操作的事。
**第二层:使用权条件(Terms)—— 这一层 Meta 只给了一部分。** 模型采用 **Muse Model License**,附带「有限的商业条款」(limited commercial terms)。具体边界是:开发者调整模型、或把它嵌进自己软件里分发,不收费;但**任何以托管服务形式转售该模型、且过去 12 个月毛收入超过 2000 万美元的公司,需要单独签署协议**;产品需带有 **「Built with Muse Spark Open」** 标识;**军事用途与关键基础设施用途被明确排除在外**。注意这几个限定:收入门槛、品牌标识、禁止用途。你下载的是权重,不是权利。**授权条款是别人写的,解释权是别人留的,修订权也在别人手里。** 你在这份模型上建的业务,它的法律地基不在你的房间里。而且要说清楚一件事:**开放权重 ≠ 开源。** 如华尔街见闻所指出的,此次开放的重点是**模型权重**,并不意味着所有训练数据、完整训练流程和研发细节均向外界公开。Meta 表示 Muse Spark Open 经过额外安全训练,并按公司内部的评估框架做过测试——但开放模型的安全边界,最终取决于后续使用者怎么部署、怎么改。
**第三层:演进主权(Roadmap)—— 这一层 Meta 明确保留。** 这是最容易被忽略、后果最重的一层。Muse Wonder 关闭着,Muse Wonder Full 只对订阅者开放。下一代的 Muse 更强版本,大概率也关着。**这意味着你选择了这条路,就等于把自己的能力上限,挂在了一个你不参与决策的时间表上。** 你等来的下一个能力档位是什么时候、什么价格、什么条款、什么附加限制——你没有一票。这和另一条新闻的本质是同一件事:当 OpenAI 通知开发者 GPT-4o 与 GPT-4.1 将于 **2027 年 1 月 14 日**从 API 移除、并给出迁移建议的时候,那些把业务建在旧模型上的团队,收到的是一个日期,不是一个选项。**(此日期目前来自中文二手报道,建议以 OpenAI 官方弃用页面为准。)** **权重让你今天不用租云端。但它没有给你对明天的决定权。**
六、那么,这次真的变了什么?
如果只讲「开放权重不等于主权」,那就变成了一篇泼冷水的文章,这不对。因为这次确实有一件事发生了实质变化,而且这个变化恰好是所有主权讨论的**物理前提**。
**算力门槛的位置,移动了。** 过去想用前沿能力,你只有两条路:租别人的云,或者准备一套只有机构才买得起的机房预算。前者你什么都不拥有,后者你根本够不到。**个人在这条线两边都不占。** 现在出现了一条中间路径,而且它被一次官方发布正式承认了:**两台桌面设备,加上一份可以下载的权重,就是一个过去只能靠机房提供的能力单元。**
代价必须说清楚:这条路一点都不便宜。据财联社报道,**512GB 版 Mac Studio 尚未开售——官方称 10 月底开售**;256GB 机型单台(配 1TB SSD)售价已超过 **1 万美元**;组建四台 256GB(合计约 1TB)的集群则需要 **4 万美元以上**。设备成本、内存需求、推理效率——本地部署的每一项限制都还在。**「能在两台 Mac Studio 上跑」不等于「普通 Mac 也能跑」。**
但这是第一次,「前沿级别的智能跑在我自己的硬件上」变成了一个**可以用钱解决的问题**,而不是一个需要先成为一家公司的资格问题。这一步的意义,不亚于整个模型榜单上的任何一次排名变化。因为它改变的不是模型的能力,是**控制权的分配位置**。
Meta 官方演示的内容也很说明问题:基于 Muse Spark Open 驱动的 Muse Code,**完全在本地设备上**跑通了多套智能体工作流——给开源 Mastodon 客户端 Ice Cubes 提交真实的 iOS 代码改动:完成漏洞修复、新增功能、完整项目构建;以及端到端操控达芬奇剪辑软件(DaVinci Resolve):逐帧审阅素材、完成竖版裁切。注意这些任务的性质:**它们不是「聊天」,是「干活」。** 一个能改代码、能剪视频、能在后台连续推进任务的智能体,跑在你的桌面上——这已经是很接近「自己的 AI 编制」的东西了。
顺带一个市场信号,说明这条路有人真的在走:Meta 9 月 8 日发布的个人智能体 Muse,据市场研究机构 Apptopia 的数据,在美加上线后 **12 天内获得约 280 万次下载**,增速超过 ChatGPT 移动端上线初期。**个人把 AI 当成「自己的编制」来用的需求,已经在被验证了。**
七、接下来看什么
这一周的新闻给了一个很清楚的观察方法:**看措辞,看限定词,看谁保留了什么。**
当一家公司说「**美国**最强开放权重模型」,那个国别前缀就是全部信息量——它在说,开放是手段,归属才是目的。当一家公司说「我们**通常**不会把最强大的模型开源」,那个「通常」就是它给自己留的后门。当一份授权叫「**有限**商业条款」,那个「有限」就是它保留的解释空间。当一份跑分表里赢两项输三项,而输的那三项对手是两个中国开源模型——那张表就是在告诉你,开放权重这条赛道上,第一名的位置正在易主。当官方演示的全部任务都是「改代码、剪视频、连续推进」,而不是「聊天」——那说明产品形态已经从**被查询**变成了**被执行**。
Meta 证明了一件事:前沿智能可以从机房里走出来。它没有证明的是另一半——走出来的这个智能,归谁管。
国家在买这一半,企业在买这一半,而个体是下一个。理由更简单:**他们一点谈判筹码都没有,所以他们需要那条捷径。**
这条捷径,和这一周所有新闻指向的是同一条:**自己的算力。自己的智能体。自己的数据。自己的规则。**
握住那个盒子。