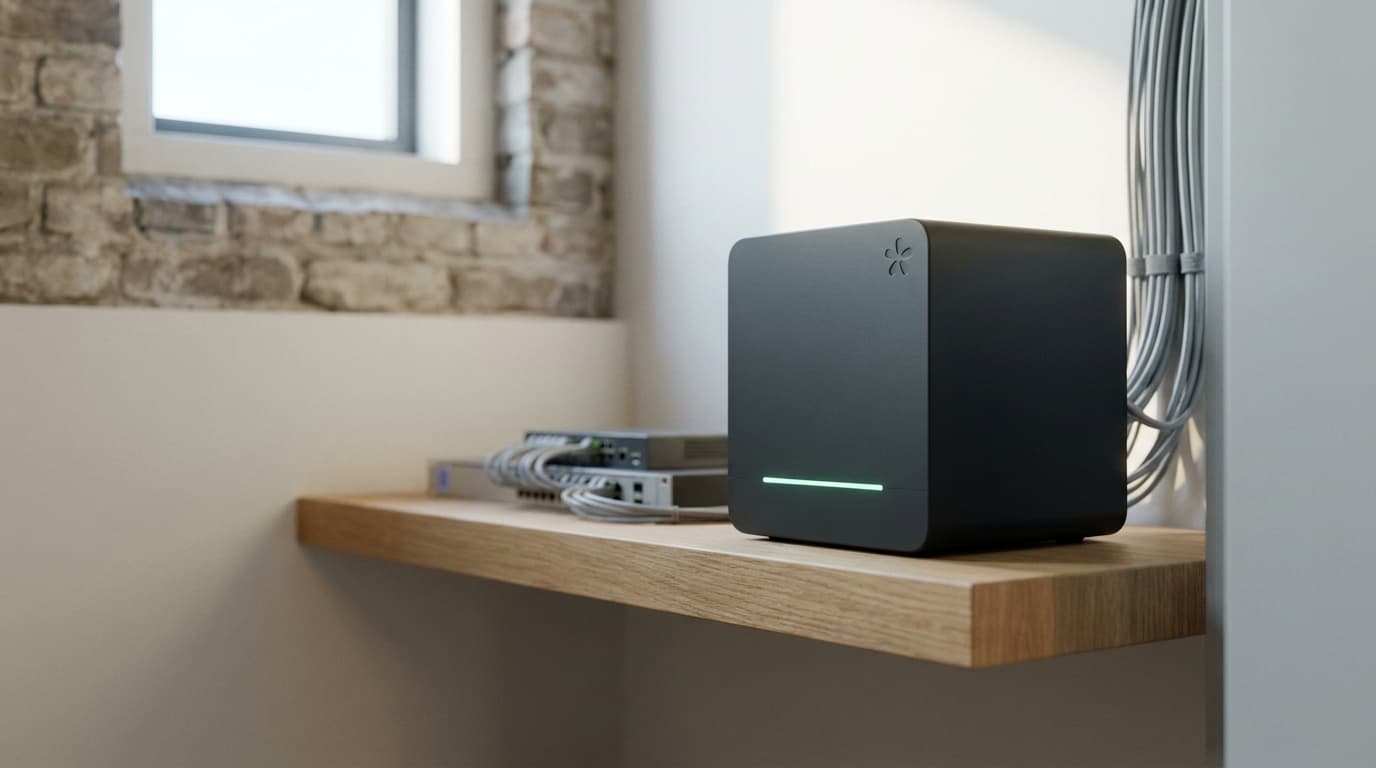
阿姆斯特丹一家 42 人的税务师事务所,沃斯与哈特曼。Q3 增值税申报季,38 家客户,10 月 31 日截止。客户档案和账套只放在事务所机房里的这台 Karma Box 上,5 位分身常驻在这台机器里 —— 文件不出这台机器,只把结果交回。
以前
- 登录 SAP/用友系统导出各科目明细和试算平衡表
- 在 Excel 中逐行核对应收应付、银行对账、调整分录
- 客户资料通过第三方云端 SaaS 处理,数据主权存疑
- 外网中断时,所有云端工具一并瘫痪,工作停摆
现在
- 碰客户档案、账套、合同的活,只派给住在盒子上的分身
- 公开法规研究、对外接待等不涉密的活,可以派给云端分身
- 外网断开时,盒子上的活照常交回;云端的活如实停下等待恢复
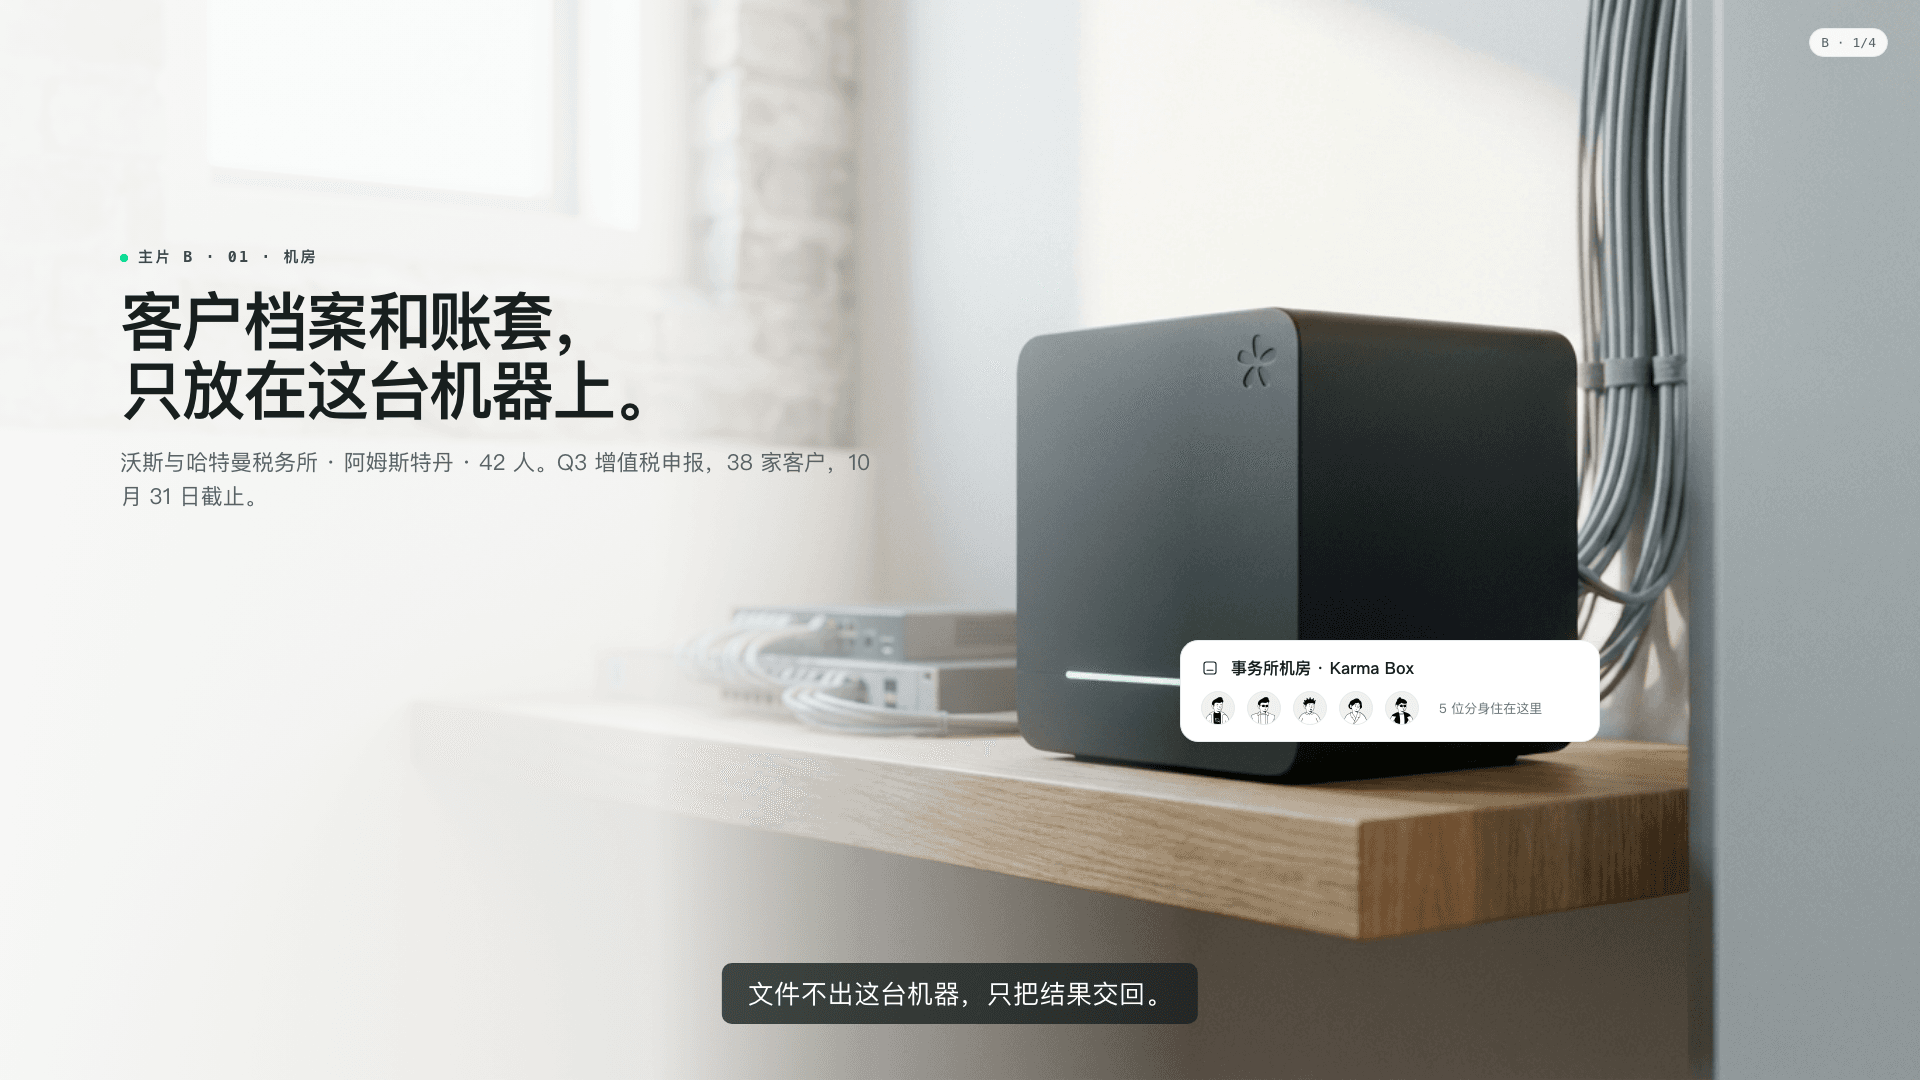
哪件活在哪里做,你说了算
事务所机房里的 5 位分身,当天交回了范德堡物流的 Q3 增值税申报表、一笔 €18,400 跨境运输服务的反向征收核对、北海医疗年度审计底稿第二册 —— 全部不涉及文件出机房。云端的 4 位分身,处理欧盟增值税新规摘要、官网访客答复这类公开或通用的事务,一条看不见的线分开了两边:客户资料不过这条线。
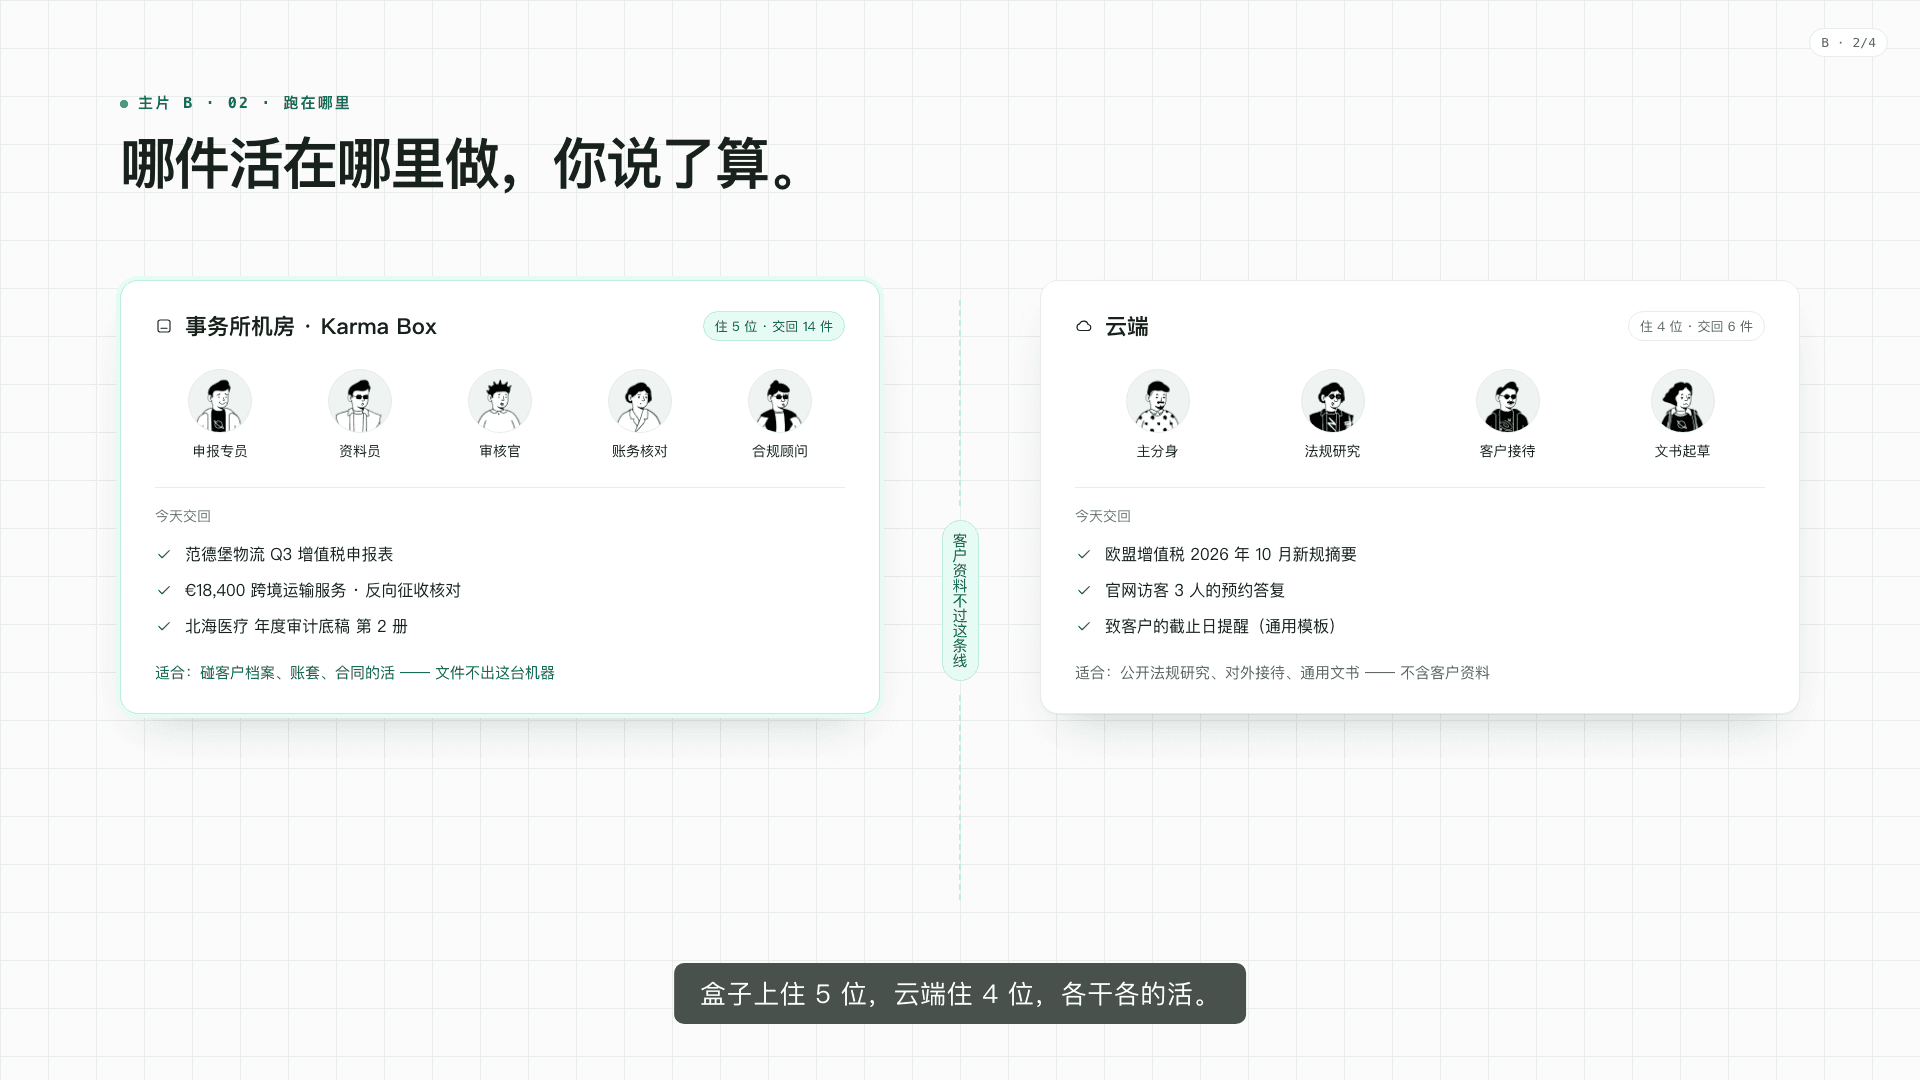
外网断了,盒子上的活照常交回
09:40 到 11:10,外网断开 90 分钟。盒子上的分身用本机模型和本机资料,不依赖外网:10:02 交回申报表初稿,10:21 交回薪资对账(发现 2 笔差异),10:38 完成 47 份研发抵免材料归档,10:55 审核通过。云端的两件事 —— 法规摘要、访客答复 —— 如实标注「等网络恢复」,11:10 网络恢复后自动续上,没有谎称完成。
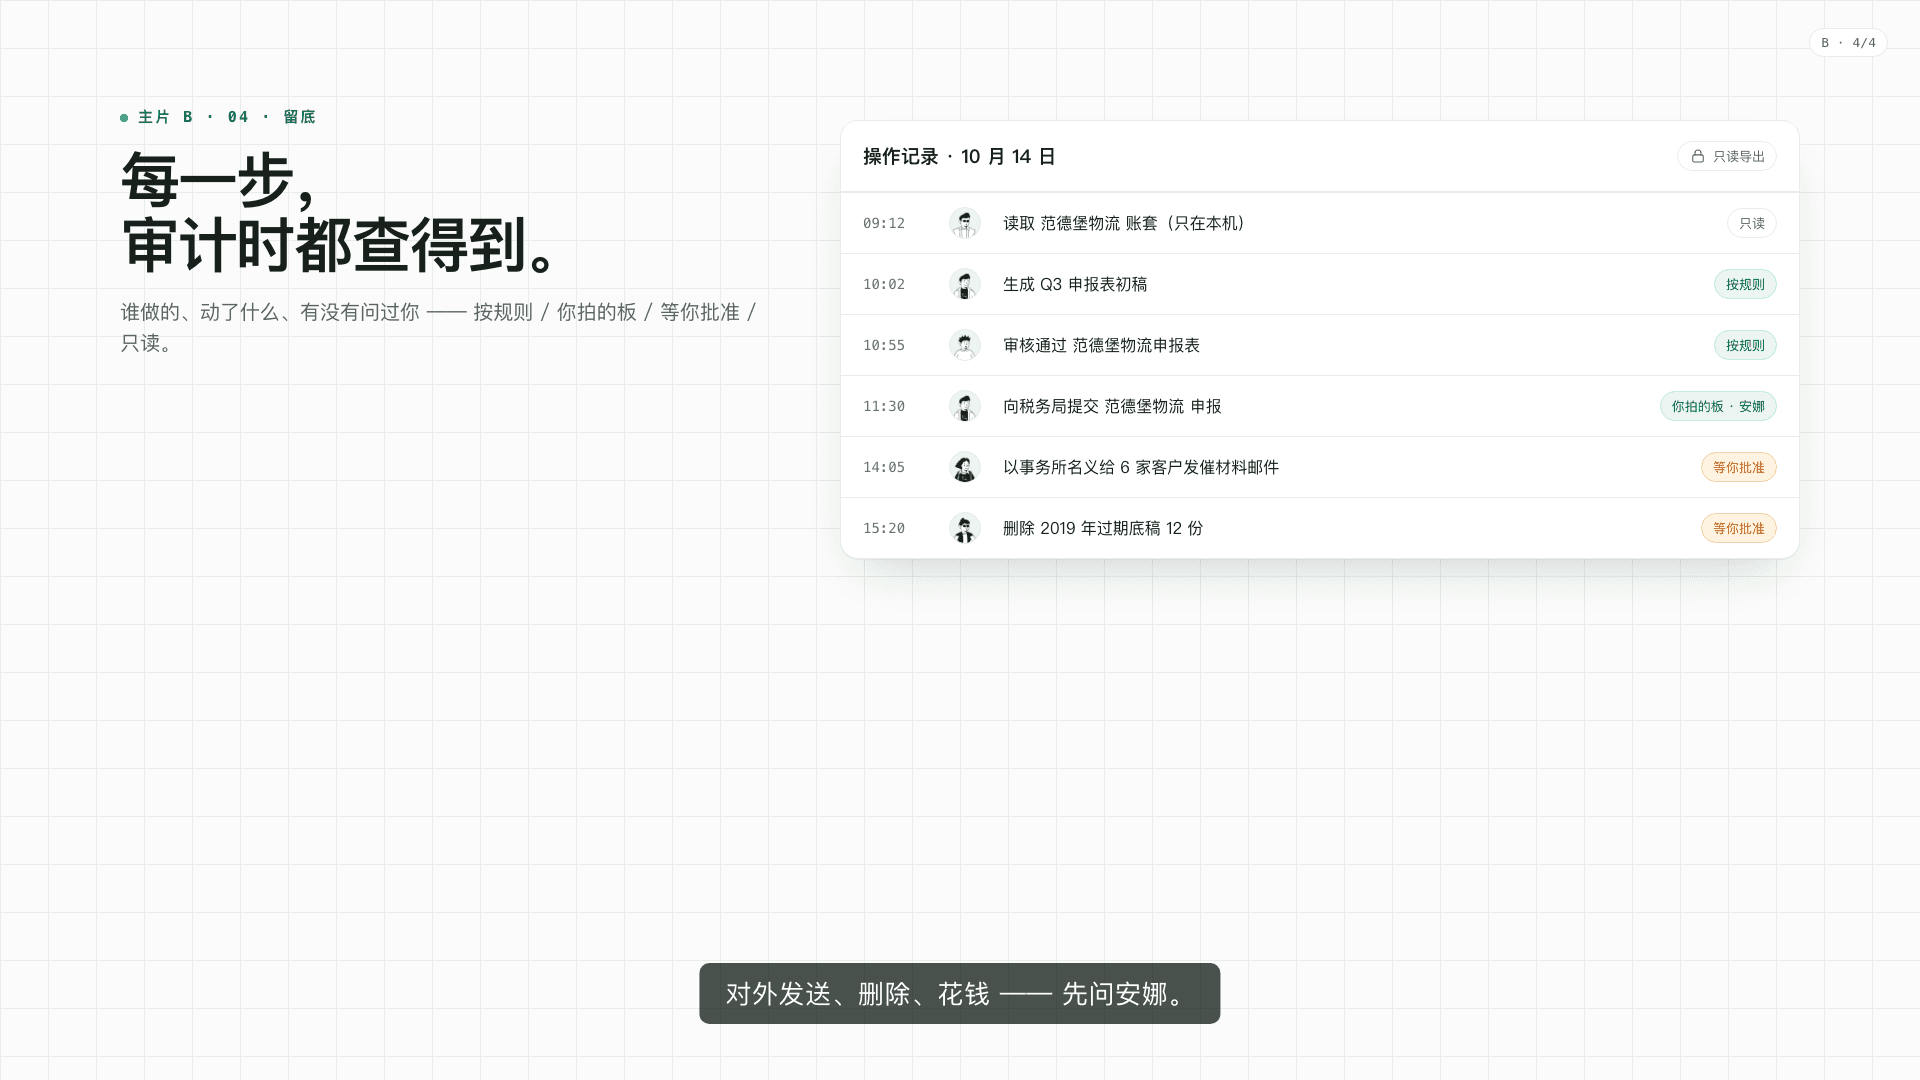
每一步,审计时都查得到
操作记录里,每一条都写清楚谁做的、动了什么、有没有问过你:09:12 读取客户账套(只读,只在本机);10:02 生成申报表初稿(按规则);11:30 向税务局提交申报(你拍的板 · 安娜);14:05 要以事务所名义给 6 家客户发催材料邮件(等你批准);15:20 要删除 12 份过期底稿(等你批准)。对外发送、删除、花钱 —— 永远先问人。
客户档案只放在你机房里的这台机器上。文件不出去,只把结果交回。
为什么「本地优先」对金融行业不是可选项
大部分行业用云端 AI 服务权衡的是便利性和成本,金融和税务行业面对的是另一个维度的问题:客户的账套、合同、身份信息一旦离开本方掌控的机器,无论服务商的隐私条款写得多严谨,事务所都丧失了对这些数据的直接控制权 —— 出了数据泄露,责任认定会变得复杂;换了云服务商,历史数据的迁移和销毁也不完全由自己说了算。沃斯与哈特曼把 5 位分身常驻在自己机房的 Karma Box 上,不是出于对技术的保守,而是因为客户资料的主权(谁能访问、存在哪里、什么时候销毁)本身就是对客户的职业承诺的一部分,这个承诺不能外包给任何第三方的服务条款。
怎么划分「必须本地」和「可以上云」的边界
不是所有任务都需要同等级别的谨慎。沃斯与哈特曼用一个简单的判断标准:这件事是否直接涉及某个具体客户的账套、合同原件或身份信息。涉及的,无论任务本身复杂还是简单,都只派给常驻机房的分身;不涉及的 —— 法规研究、通用问答、官网访客接待 —— 可以派给云端分身处理,换取更低的延迟和更强的模型能力。这条线一旦划定,就应该写进制度而不是留给每次任务临时判断,这也是为什么审计记录里「哪件活在哪台机器上做」本身就是一项可检查的合规项,而不只是技术实现细节。
接入本地优先工作流的四个步骤
1. 先盘点哪些数据真正算「涉密」。客户账套、合同原件、身份证明文件属于明确涉密范围;行业新规、公开的税率表、内部培训材料通常不属于。把这条边界写清楚,而不是凭直觉每次临场判断。 2. 把涉密任务全部收口到本机分身。哪怕只是「读一下这份合同有没有特殊条款」这类看起来无害的小任务,只要涉及具体客户的原始文件,就应该走本机,不走云端。 3. 为断网场景做一次真实演练。提前确认本机分身在没有外网时,能不能独立完成申报表起草、对账这类核心工作 —— 不要等真正断网时才发现某个环节悄悄依赖了云端。 4. 把审批节点写进流程,而不是写进文档。对外提交申报、对外发送邮件、删除历史文件,这类动作应该在系统层面设置成必须等人工批准才能执行,而不是靠内部规定「口头要求」分身自觉遵守。
怎么衡量这套工作流有没有真的可靠
不要只看「平时响应快不快」,真正的考验在意外发生时:断网这类场景下,本机核心任务的完成率有没有保持不变(这是本地优先架构存在的意义);审计记录的完整度(随机抽查几条操作,能不能一次性查到完整的执行依据和审批记录,而不是需要人工拼凑);审批节点的实际响应时间(如果「等待批准」的任务经常堆积数小时无人处理,说明审批流程本身而非技术架构才是瓶颈);以及跨子公司、跨法域任务的交叉验证准确率,这类合并报表类工作最容易在细节上出偏差。
常见误区
最常见的误区,是把「本地优先」理解成「完全不碰云」,结果放弃了云端模型在处理公开信息时更强的能力和更低的成本 —— 本地优先的核心是数据主权的边界,不是技术选型上的洁癖,公开、非涉密的任务完全可以上云。其次是把断网演练当成一次性的验收,做完就不再复查 —— 系统升级、新增任务类型,都可能悄悄引入新的云端依赖,需要定期重新验证。还有一种误区是审批节点设置得过多过细,导致真正紧急的任务也被卡在批准队列里,审批应该聚焦在外发、删除、花钱这类不可逆或影响第三方的动作上,而不是事无巨细全部要人工点头。
常见问题
本机分身的能力会不会比云端模型弱? 在通用知识广度上,本机模型通常不如最强的云端模型;但对账、核对、归档这类任务依赖的是规则执行的准确性而非广博的知识面,本机模型完全胜任,且避免了数据出域的风险。 如果事务所有多地分支,Karma Box 怎么部署? 每个有独立客户资料的分支机构可以各自部署一台 Karma Box,分身常驻在产生数据的本地机器上,而不是集中到某一处再统一处理。 审计记录能不能被事后篡改? 操作记录应作为只读的审计轨迹保留,正常业务流程不提供删除或修改历史记录的入口;如涉及监管要求的记录留存年限,应遵循当地金融监管规定执行。
一个季度之后,事务所学到了什么
Q3 增值税季结束之后,沃斯与哈特曼回顾了这一个季度的数据:5 位常驻分身处理了 38 家客户里 31 家的首轮申报草稿,剩下 7 家因为账目本身有历史遗留问题,仍需要合伙人从头介入——这个比例被当作下一季度要重点清理的对象,而不是被忽略。90 分钟那次断网,是整个季度唯一一次网络中断,但复盘时事务所发现了一个没预料到的问题:云端的两位分身在网络恢复后自动续上了任务,但其中一位把断网期间客户通过邮件追加的一个问题漏掉了,因为它只在恢复连接的那一刻检查了一次新消息,而不是持续监听。这个细节后来被写进了内部的运维清单——任何依赖网络的分身,断网恢复后都需要人工确认一遍是否有遗漏,而不是默认「恢复了就等于没出过问题」。审计记录在这一个季度里被实际用上了一次:一位客户对某笔申报的时间线提出疑问,事务所从记录里在几分钟内调出了完整的操作链条,包括谁在什么时间点批准了提交——这件事此前从未发生过,但事务所意识到,这正是最初决定做本地优先架构时,最想换来的那种确定性。
在把本地优先工作流用于正式的客户申报和审计交付之前,建议先用一个完整的断网演练和一轮抽样审计检查,确认核心任务在无网络环境下的完成率和审计记录的完整度都达到事务所内部标准,再推广到全部客户账套。