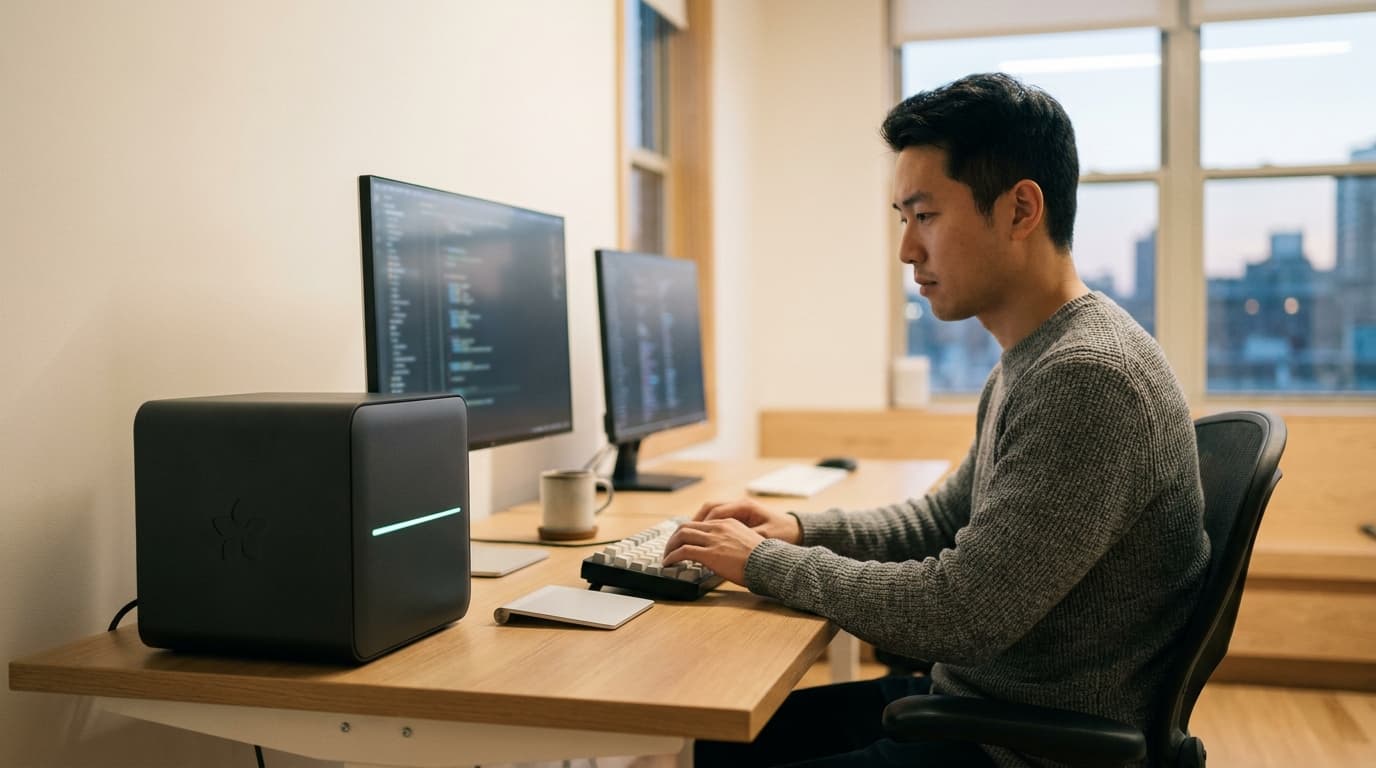
小程序下单页有客人反馈:选了燕麦奶,价格还是按牛奶算的,好几个客人都问了。这类问题过去要靠工程师排队认领、复现、定位,再评估修复风险 —— 现在交给「匠人·研发」分身,全程跑在研发自己的 Karma Box 上,读写代码不出这台机器。
根因已定位
10:20,店主在群里报了问题;10:34,分身回复根因已定位:价格计算读取的是商品默认规格,没有读顾客实际选择的规格 —— cart/price.ts:142。它先写了一条会失败的测试来复现问题,并标注「跑在研发的 Karma Box · 读写代码要本机身体」,而不是直接动手改代码。
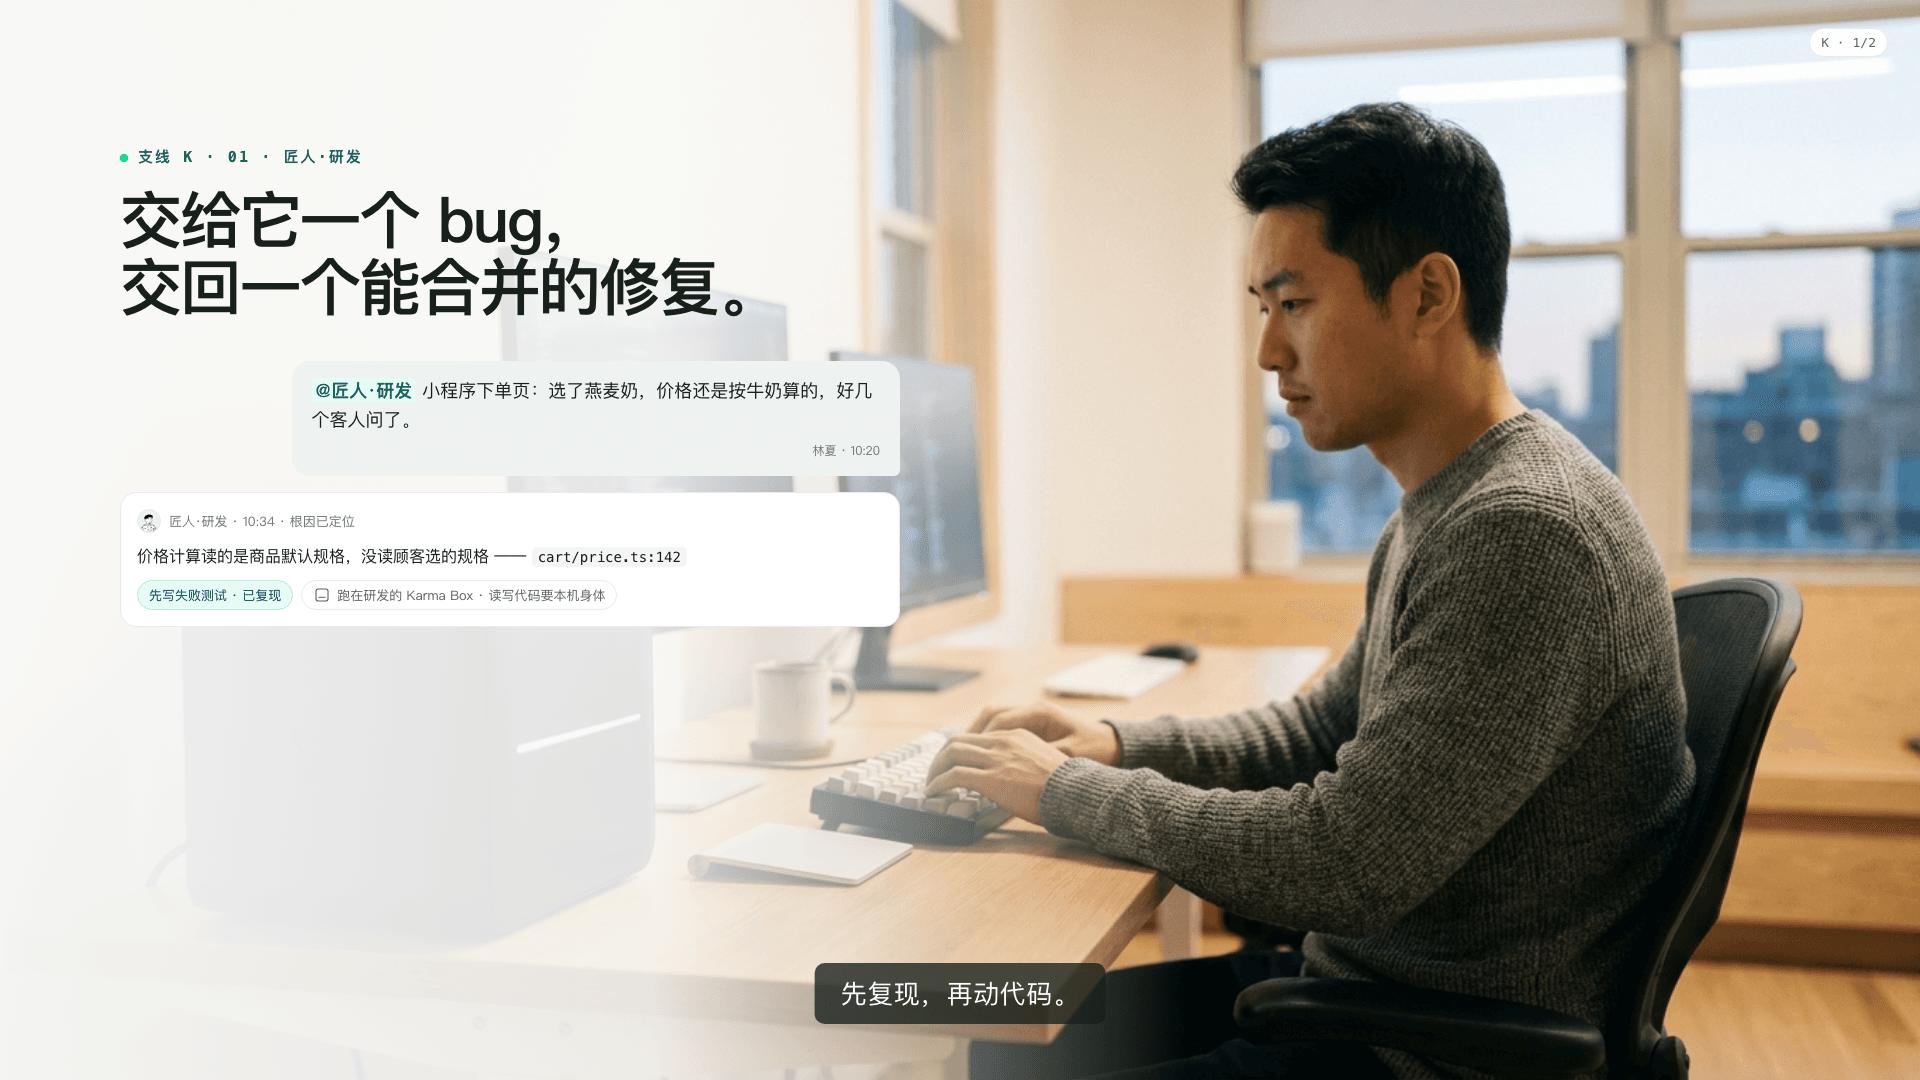
测试先红后绿,合并前先问你
分身对着当前版本写代码,不凭记忆写 API。改动只有一行逻辑:按顾客选择的规格 ID 查找对应价格,找不到才回落到默认规格。修复前,price.spec.ts 显示选燕麦奶应得 ¥31,实得 ¥28,1 项测试失败;修复后 3 项全部通过,其中包含一条「不选规格时回落默认」的阴性用例,专门防止回归。
合并、上线这类动作永远等你点头 —— 交回的是能合并的修复,不是一段建议。
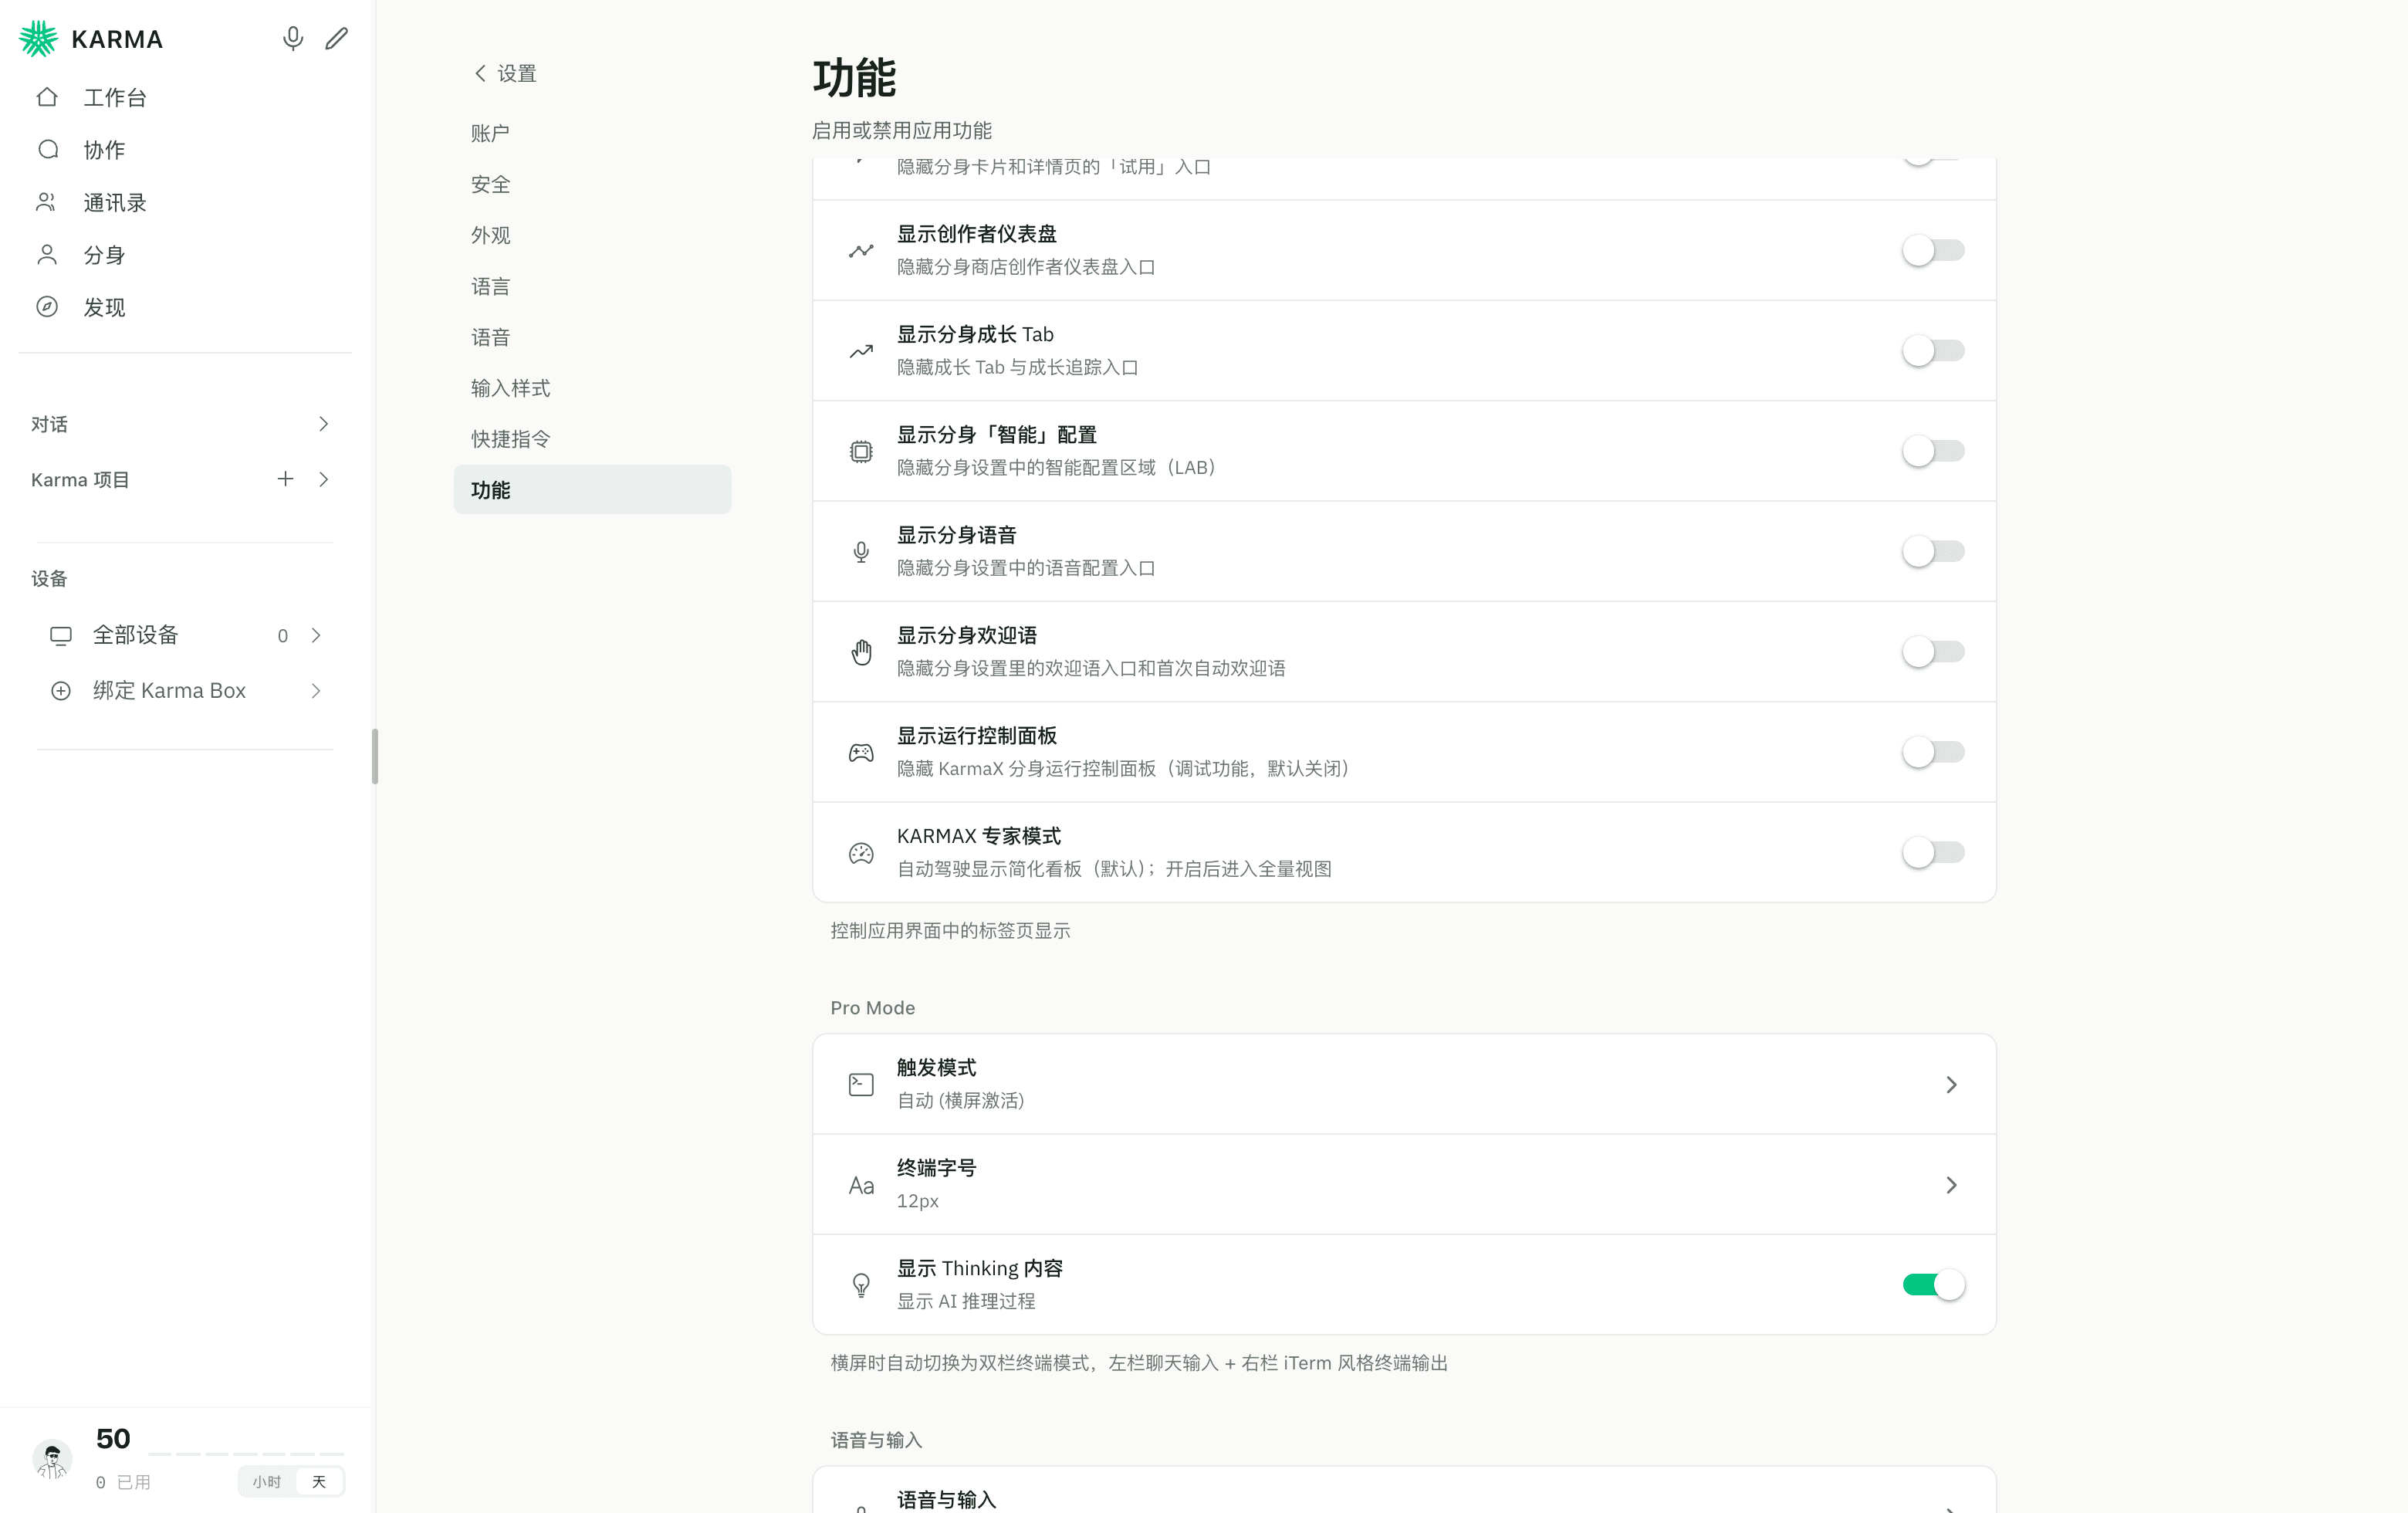
真实产品界面:研发工厂
以上是场景演示;在真实产品里,这套能力由「研发工厂」承载 —— 面向实际代码仓库的工程分身团队,能读写代码、跑测试、开合并请求,并在面板里展示每一步的进度和产出。
为什么不能只是「把代码库丢给大模型」
把 bug 描述粘进一个通用聊天窗口,模型也能给出一段看起来合理的补丁 —— 但它是凭训练数据里的「印象」写的 API,不是对着你此刻的代码库写的。它不知道 cart/price.ts 这周刚被人改过,不知道 specs 字段上个月从数组换成了 Map,也不会在落笔前去跑一遍现有测试。研发工厂要解决的正是这件事:分身必须先读仓库的当前状态,再动笔;必须先写一条会失败的测试复现问题,再改代码;改完必须让测试转绿,而不是口头保证「应该修好了」。这三条顺序锁死了,不是因为流程好看,而是因为跳过任何一步,修复就可能是错的,却看起来很像对的。
四步把它接进你的研发流程
1. 先连仓库,不连「权限」。把研发工厂接到你实际使用的代码仓库(而不是导出的一份快照),让它一直读到最新提交;但初期只给它开 merge request 的权限,不给它直接合并到主分支的权限 —— 合并永远是人工点头的一步。 2. 从一类低风险 bug 开始。价格计算错误、文案拼写、过期的配置项,这类任务后果可控、容易验证,适合用来建立对它输出质量的信任,再逐步扩大到更复杂的改动。 3. 要求先测试、后代码。无论你用不用研发工厂自带的流程,都应该明确要求它先写能复现问题的失败测试,再提交修复 —— 这是判断一次修复是否「真的修好」最可靠的证据,而不是它自己的描述。 4. 把合并请求当作审查对象,而不是最终结果。每一个合并请求都应该像同事提交的一样经过 code review:改动范围是否超出预期、是否引入了新的依赖、测试是否真的覆盖了原问题。
怎么判断这套流程有没有在真的省时间
不要只看「分身回复了」就算数,要看几个更具体的指标:从报告问题到交回可合并修复的时长;合并请求被退回重做的比例(退回率越高,说明它对代码库的理解还不够,需要更小范围的任务);新增测试里阴性用例的占比(只验证正向路径的修复容易在下一次改动时悄悄回归);以及人工 review 实际花费的时间有没有真的比自己从头修复更短 —— 如果每个合并请求都要你逐行重写,这套流程就只是把工作挪到了别处,而不是真的省了时间。
常见误区
最常见的误区,是把「测试通过」当成「修复正确」的充分证据 —— 测试本身也可能写得不对,或者只覆盖了报告里提到的那一种情况,漏掉了相邻的边界条件。其次是过早放开自动合并权限:合并请求数量上来之后,团队容易因为「看起来一直是对的」而放松逐条审查,这正是风险开始累积的时候。还有一种误区是把研发工厂当成能替代代码评审的工具,而不是加速代码评审准备工作的工具 —— 它能把定位、复现、修复这三步做得很快,但「这个改动是否符合这个产品现在的方向」仍然需要人来判断。
常见问题
它能处理多大的改动? 适合从小范围、可独立验证的改动开始 —— 单文件 bug 修复、局部重构、补充测试覆盖。跨越多个模块、涉及架构决策的改动,建议先由人工拆解成更小的任务再派发。 代码会不会被发到外部服务器? 研发工厂可以运行在你自己的 Karma Box 上,读写代码的过程不出这台机器;是否连接云端模型处理非敏感环节,由你决定。 如果它的修复是错的,怎么追责和回滚? 每个合并请求都有完整的改动记录和对应的测试结果,出问题时可以精确定位到哪一次合并引入了问题,和人工提交的代码走同一套版本控制与回滚流程,没有特殊通道。
一个真实团队的采用过程
一个 6 人的小程序团队第一周只做了一件事:把研发工厂接到仓库,权限设成「只能开合并请求,不能合并」,然后派发了过去一个月里优先级最低、一直没空处理的 11 个小 bug。第一周交回 9 个合并请求,7 个一次通过,2 个因为测试覆盖不够被打回重写。第二周,团队把「退回重写」的 2 个案例喂回去做参照,同时开始派发中等复杂度的任务 —— 涉及两个文件、需要理解一点业务逻辑的那种。到第四周,团队测算下来,这类小修复从「有空再弄」变成了「当天能交回」,腾出来的时间被重新投到了之前一直没空做的性能优化上。整个过程里,没有一次合并是自动发生的 —— 技术负责人每天固定花 20 分钟集中审查当天的合并请求,这 20 分钟后来被证明比过去分散在一周里处理同样数量的 bug 加起来要短得多。
在把研发工厂接入任何涉及生产环境、支付链路或用户数据的代码路径之前,建议先用非关键模块验证它的修复质量、合并请求的规范程度,以及团队实际的审查节奏,再逐步扩大范围。